需导入调试自定义音色:一、准备10–30秒纯净干声WAV/MP3音频,采样率≥16kHz、单声道;二、官网控制台上传并命名;三、等待训练完成(2–5分钟)后试听校验;四、在视频项目中手动绑定音色;五、异常时可调参或分句微调。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜
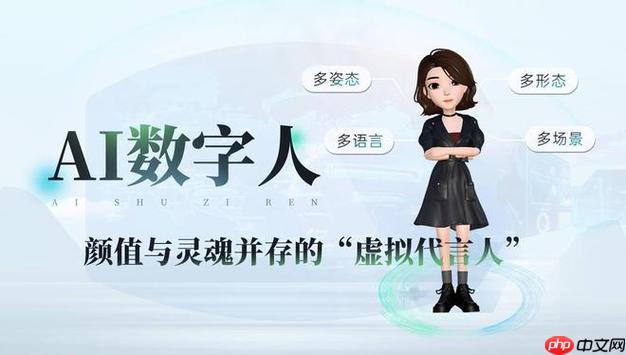
如果您已在“有言AIGC数字人”平台完成3D形象创建,但希望为数字人匹配专属语音风格,则需导入并调试自定义音色。以下是具体操作路径与技术要点:
一、准备符合规范的音频文件
自定义音色上传前,必须确保音频满足平台硬性要求,否则系统将拒绝识别或生成异常音色。关键参数包括采样率、时长、信噪比及内容连贯性。
1、使用手机录音功能或专业软件录制一段10–30秒的纯净人声音频,内容为自然语速朗读的连贯中文句子(如“今天天气很好,我们一起去公园散步吧”);
2、录音环境须绝对安静,关闭空调、风扇、电视等干扰源,避免回声与背景杂音;
3、导出格式限定为WAV或MP3,采样率不低于16kHz,位深度为16bit,单声道;
4、禁止使用变声器、混响插件、降噪过度处理,原始干声最适配模型训练。
二、在控制台完成音色上传与命名
平台通过独立音色管理模块接收用户音频,并建立唯一ID绑定至账户下所有可用形象,支持多音色并存与快速切换。
1、登录有言官网(https://www.youyan3d.com/platform),进入“我的音色”控制台;
2、点击“新建音色”按钮,弹出上传窗口;
3、拖入已准备好的音频文件,或点击区域选择本地文件;
4、在“音色名称”栏输入不超过12个汉字的标识名(如“张三-会议播报”“李四-客服女声”),便于后续项目调用;
5、勾选“我确认该声音为本人所有并授权用于AI合成”,点击“提交上传”。
三、触发音色模型训练与状态校验
上传成功后,平台自动启动轻量级声学建模流程,不依赖用户持续在线,但需主动确认训练完成状态以进入试听环节。
1、返回“我的音色”列表页,找到刚提交的条目,状态显示为“训练中”;
2、等待2–5分钟(网络稳定前提下),状态自动更新为“就绪”;
版权声明:除非特别标注,否则均为本站原创文章,转载时请以链接形式注明文章出处。
还木有评论哦,快来抢沙发吧~